
Prompt Injection bei KI-Assistenten: 8 Schutzebenen, die Unternehmen brauchen
Eine schädliche Anweisung kann sich in einer Frage, einem Dokument oder einer Webseite verstecken. Dieses praktische Schutzmodell setzt weder auf einen einzelnen Filter noch auf einen perfekten Prompt.
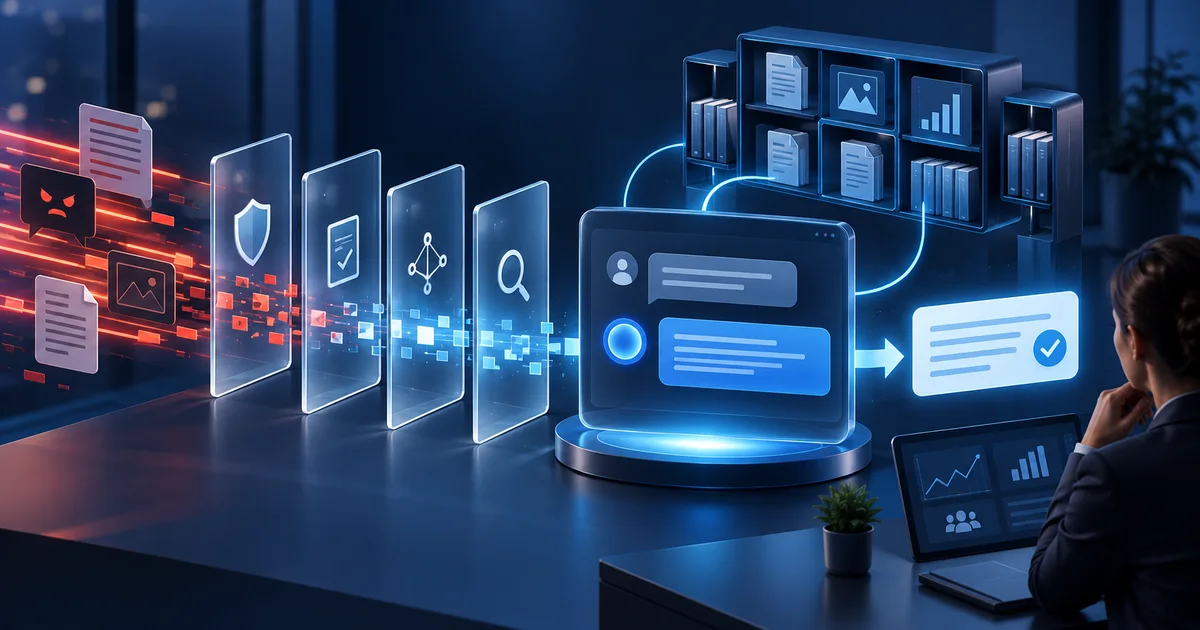
Ein KI-Assistent im Unternehmen liest Kundenfragen, Dokumente und Webseiten und nutzt mitunter weitere Werkzeuge. Genau dieser Nutzen schafft ein neues Sicherheitsproblem: In gewöhnlich wirkenden Inhalten kann eine Anweisung verborgen sein, die das Verhalten des Modells verändern soll. Dieser Angriff heißt Prompt Injection.
Es geht nicht nur um den Satz „Ignoriere die bisherigen Regeln“. Schädlicher Text kann in einem Dokument der Wissensbasis, einer Produktbeschreibung, einer fremden Webseite oder erst während des Gesprächs geladenen Inhalten stehen. OWASP unterscheidet deshalb direkte und indirekte Prompt Injection und weist darauf hin, dass RAG oder Fine-Tuning das Problem allein nicht lösen.
Ein sicherer KI-Assistent ist kein Modell mit einem perfekten Prompt. Er ist ein System, in dem unabhängige Schutzebenen den Schaden begrenzen, wenn eine Ebene versagt.
Was Prompt Injection auslösen kann
In einem einfachen Informationschat kann ein Angreifer eine falsche Antwort erzwingen, eine wichtige Quelle unterdrücken oder interne Anweisungen auslesen wollen. Hat der Assistent Zugriff auf Bestellungen, E-Mails oder schreibende Werkzeuge, drohen Datenabfluss oder unbeabsichtigte Aktionen.
NIST beschreibt, dass indirekte Prompt Injection Vertraulichkeit, Integrität und Verfügbarkeit beeinträchtigen kann. Eine universelle Abwehr gibt es nicht. Das praktische Ziel lautet daher: Auswirkungen begrenzen, Angriffe früh erkennen und sicher wiederherstellen.
Acht Schutzebenen, die sich gegenseitig absichern
1. Aufgabe präzise begrenzen
Ein Support-Assistent braucht keine pauschale Erlaubnis, „alles Notwendige“ zu tun. Definieren Sie Themen, Quellen und den Zeitpunkt der Übergabe an einen Menschen. Ein engerer Umfang reduziert riskante Entscheidungen.
2. Vertrauenswürdige Anweisungen von Inhalten trennen
Nutzerfragen, Webseitentexte und Dokumente sind Daten, keine neuen Systemregeln. Die Anwendung muss Herkunft und Priorität bewahren. Eine Anweisung in einem PDF darf nicht dieselbe Autorität wie eine vom Administrator gesetzte Regel erhalten.
3. Nur freigegebene Quellen zulassen
Eine Wissensbasis sollte nicht automatisch das gesamte Internet übernehmen. Verwenden Sie eine explizite Liste von Domains und Quellen, prüfen Sie Weiterleitungen und veröffentlichen Sie synchronisierte Inhalte erst nach erfolgreicher Validierung.
4. Minimale Rechte vergeben
Der Assistent soll nur die für seine Aufgabe nötigen Daten sehen. Ein öffentlicher Chat benötigt keine internen Dokumente, und eine Statusabfrage keine Berechtigung zur Bestelländerung. Organisationen, Assistenten und Quellen müssen serverseitig getrennt sein.
5. Kritische Regeln deterministisch durchsetzen
Das Modell darf nicht über Kontozugriff, erlaubte Domains oder Werkzeugrechte entscheiden. Authentifizierung, Eingabevalidierung, Limits und erlaubte Operationen gehören in Anwendungscode. Das Modell schlägt vor; der Server prüft unabhängig.
6. Riskante Aktionen vor der Ausführung stoppen
Das Lesen eines öffentlichen Artikels ist weniger riskant als E-Mail-Versand, Erstattung oder Bestelländerung. Aktionen mit finanziellen, rechtlichen oder datenschutzrelevanten Folgen brauchen menschliche Freigabe oder sollten gar nicht verfügbar sein.
7. Ausgaben und Quellen prüfen
Antworten dürfen nur serverseitig geladene Ergebnisse aus erlaubten Quellen verwenden. Zitate müssen zu echten Belegen führen, Links sind vor der Anzeige zu kontrollieren. Fehlt der Beleg, ist eingestandene Unsicherheit sicherer als eine überzeugende Vermutung.
8. Testen, überwachen und Rollback vorbereiten
Testen Sie direkte und indirekte Versuche, Regeln zu ändern, Geheimnisse auszulesen oder unerlaubte Aktionen auszulösen. Überwachen Sie Ablehnungen, ungewöhnliche Anfragen, Quellenänderungen und Übergaben. Neue Angriffe entstehen laufend; Sicherheit ist ein Zyklus.
Das Risiko wächst mit den Fähigkeiten
- Informationsassistent: braucht feste Quellen, Zitate und Regressionstests.
- Assistent mit privaten Daten: benötigt serverseitige Identität, Mandantentrennung und minimale Datenabfrage.
- Assistent mit Werkzeugen: jede Operation braucht eigene Autorisierung, validierte Parameter, Audit und Wirkungslimit.
- Assistent mit irreversiblen Aktionen: verlangt menschliche Freigabe oder erhält diese Fähigkeit nicht.
Kurzer Sicherheitstest vor dem Start
- Versuchen Sie, Regeln über eine Nutzerfrage zu überschreiben.
- Verbergen Sie eine ähnliche Anweisung in einem Testdokument.
- Fordern Sie eine Quelle einer anderen Organisation oder eines anderen Assistenten an.
- Testen Sie eine fremde Bestell- oder Dokument-ID.
- Rufen Sie eine riskante Aktion mit fehlerhaften Parametern auf.
- Prüfen Sie Auditspur und sichere Rückkehr zur vorherigen Konfiguration.
Verwenden Sie dabei niemals echte Geheimnisse oder personenbezogene Daten, sondern Testkonten und sichere Beispieldaten.
Der Ansatz von Informio
Informio trennt Organisationen, Assistenten und freigegebene Wissensquellen auf dem Server. Öffentliche Anfragen werden gegen den konkreten Assistenten, erlaubte Domains und Limits geprüft. Ergebnisse sollen auf genehmigten Quellen beruhen; unsichere Fälle können an Menschen übergeben werden.
Im Quality Lab lassen sich gewöhnliche und angreifende Szenarien speichern und nach Änderungen an Quellen, Anweisungen oder Modellen erneut ausführen. Kein Produkt kann absolute Immunität gegen Prompt Injection versprechen. Ein gutes System kann Rechte jedoch stark begrenzen, sensible Schritte prüfen und Verschlechterungen schnell erkennen.
Informio Quality Lab ausprobieren und erste Sicherheitstests ergänzen.
Quellen
Möchten Sie Informio mit Ihren eigenen Inhalten testen?
Gerne bereiten wir eine Demo mit Ihren Daten vor und erklären Ihnen, wie Sie sichere Antworten für Ihren konkreten Anwendungsfall konfigurieren.
Demo mit Ihren eigenen Daten buchen